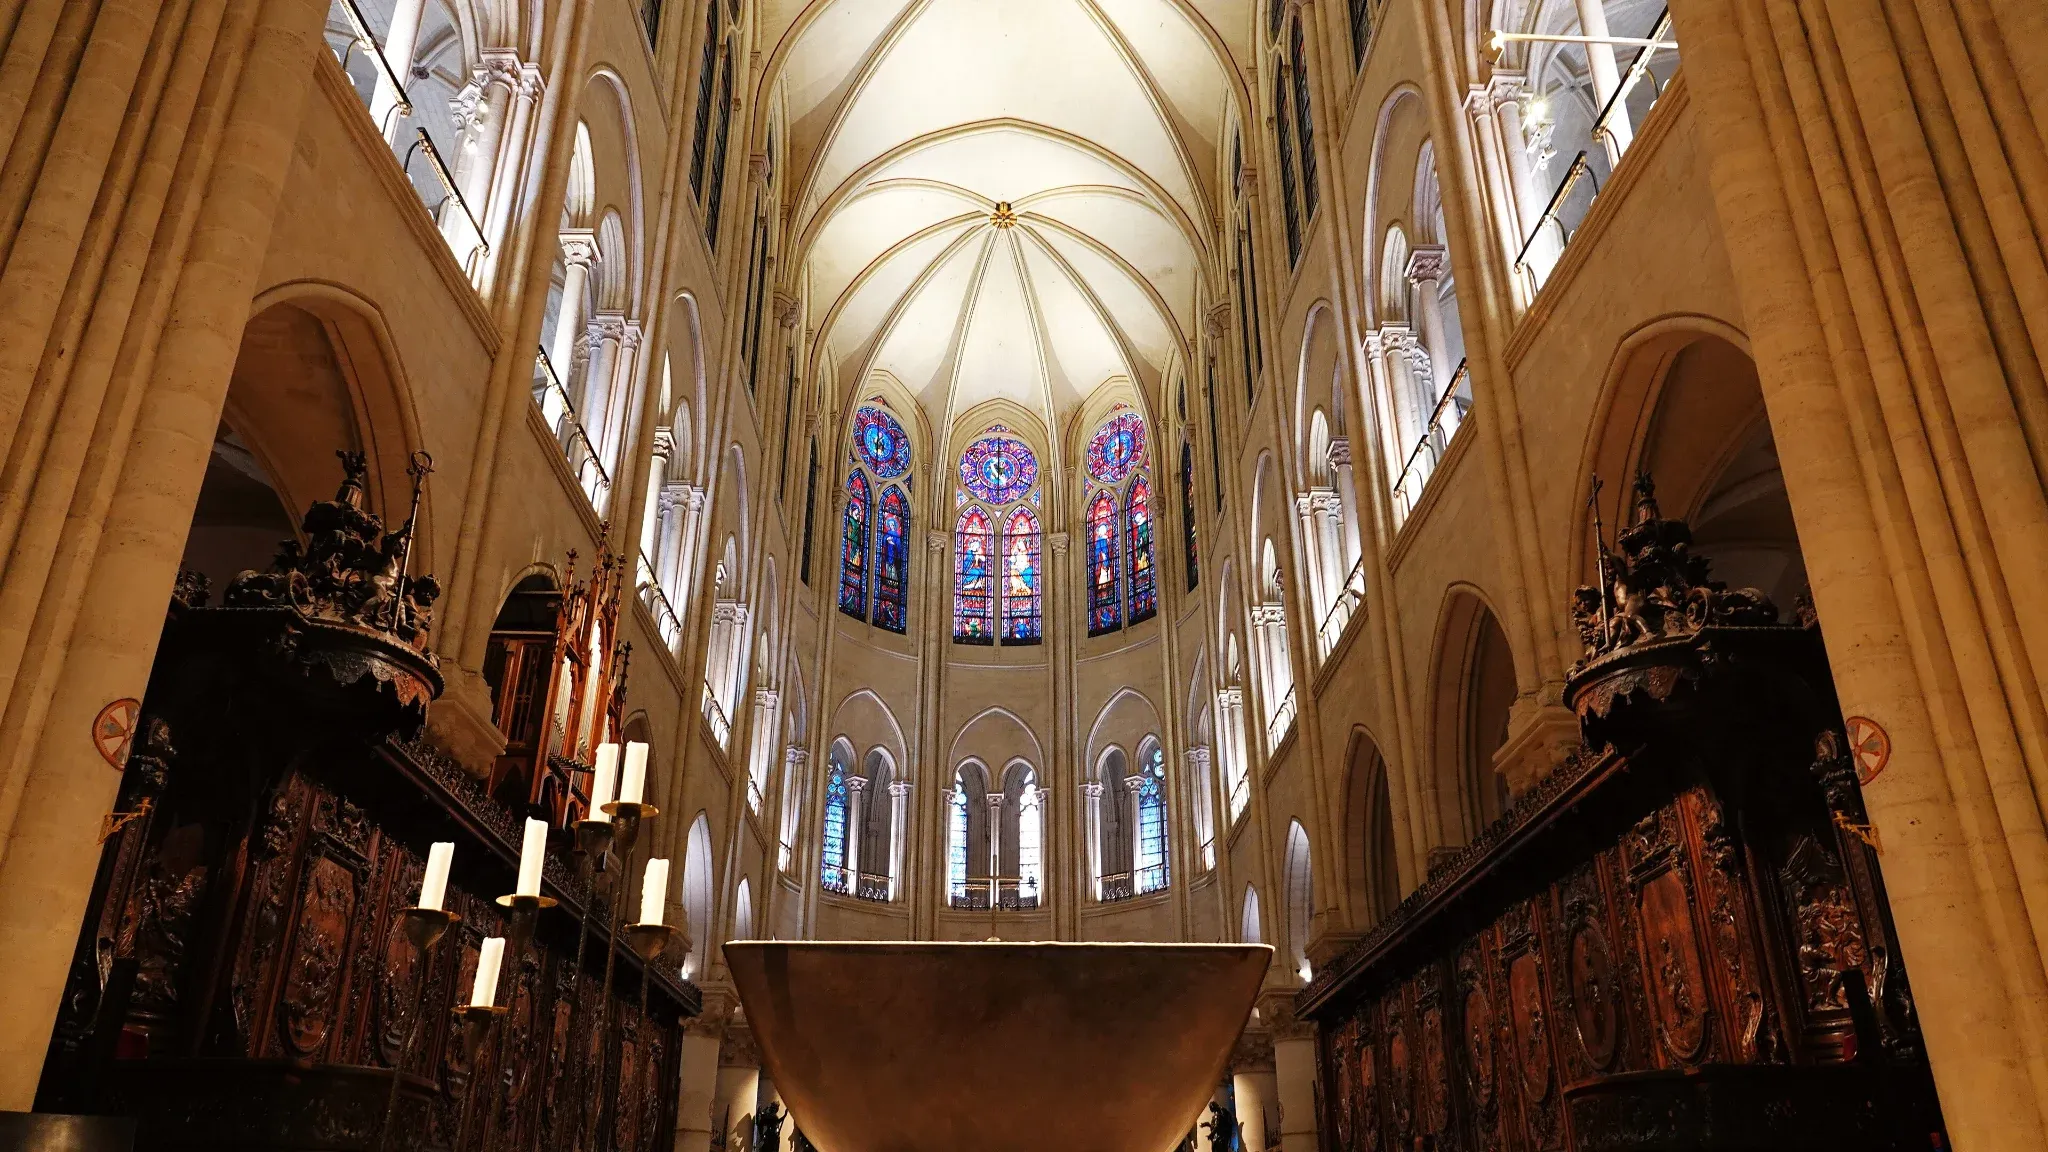
Des historiens ont appris à une intelligence artificielle à lire les registres manuscrits de Notre-Dame de Paris, des documents vieux de plusieurs siècles que personne n'avait encore transcrits. Selon Amphisciences, qui rapporte ce travail le 21 octobre 2026, la machine reconnaît aujourd'hui entre 88 et 94 % des caractères, et 14 600 pages deviennent cherchables en quelques secondes.
Voilà une nouvelle qui parle de silences retrouvés. Dans ces registres dorment des enfants trouvés, un chanoine ivre excommunié, des vies minuscules que l'histoire officielle n'a jamais invitées à sa table. La mémoire des peuples ne vit pas seulement dans les cathédrales. Elle vit dans les listes, les comptes, les notes griffonnées à la volée par des notaires pressés. Ces traces-là, longtemps illisibles, remontent aujourd'hui à la lumière.
Comment apprend-on à une machine à lire une écriture morte
L'outil s'appelle la reconnaissance d'écriture manuscrite, ou HTR. C'est un réseau de neurones artificiels : un programme qui apprend à partir d'exemples, non à partir de règles écrites par un humain. On lui montre l'image d'une ligne manuscrite et le texte exact qu'elle contient. À force de comparaisons, il associe des formes à des lettres, un peu comme un enfant qui suit du doigt un texte qu'on lui lit à voix haute.
Pour Notre-Dame, l'équipe a entraîné deux modèles. Le premier repère les zones de texte et les lignes sur la page, le second les lit. Le point de départ tenait en une cinquantaine de pages déjà transcrites par les chercheurs. Tout s'est fait sur eScriptorium, une plateforme libre conçue par l'École nationale des chartes et l'Inria. Une quinzaine d'historiens ont ensuite corrigé les résultats, et sept versions successives du modèle de lecture ont vu le jour. Les premiers entraînements ont eu lieu entre novembre 2021 et janvier 2022, avant des ateliers de correction collective à partir d'octobre 2022.
Il y a la diversité des mains, aussi, car chaque scribe a ses habitudes. Sur un corpus de plus de 200 manuscrits médiévaux, le modèle se trompe sur moins de 5 % des caractères quand il connaît déjà les écritures. Face à des manuscrits jamais vus, son taux d'erreur dépasse 13 %. Et aucun modèle existant n'avait appris l'écriture des notaires qui prennent des notes à la volée.
Le travail des mains compte autant que l'algorithme
Voici peut-être la leçon la plus belle de cette histoire : la machine n'a rien volé aux humains. Le travail de correction compte autant que l'algorithme. Pour qu'un modèle progresse, ses exemples doivent suivre des règles constantes. Il faut noter de la même façon une abréviation, une lettre douteuse, un mot coupé. Des données hétérogènes brouillent l'apprentissage. Des données cohérentes donnent au contraire des modèles réutilisables par d'autres équipes.
C'est une communauté de savoir qui s'est constituée,main dans la main avec l'outil. Une quinzaine d'historiens penchés sur les mêmes lignes, des ateliers collectifs, des corrections patientes. La connaissance, ici, ne s'est pas achetée. Elle s'est construite, partagée, sur une plateforme libre. Voilà une voie que nous connaissons bien à Madagascar, celle du bien commun contre l'appropriation privée.
88 à 94 % des caractères reconnus : est-ce suffisant ?
Le modèle a transcrit 90 % du texte des registres. Son taux de reconnaissance varie de 88 à 94 % selon les volumes, et il se mesure lettre par lettre. Les spécialistes parlent de taux d'erreur par caractère : la part des caractères mal reconnus par rapport au texte exact. Concrètement, sur 100 lettres, la machine en rate entre 6 et 12.
Cela paraît peu, mais une seule lettre fausse suffit à abîmer un mot. Dans un test sur un autre manuscrit médiéval, environ 7 % d'erreurs par caractère laissaient près d'un mot sur cinq à corriger. Le texte de la machine n'est donc pas une édition prête à citer. C'est un brouillon que l'historien vérifie. Pour éditer un registre complet, il faut toujours relire chaque ligne.
Un brouillon qui change tout pour la recherche
Ce brouillon change pourtant les conditions du travail. Il devient possible de chercher un nom, un lieu ou un mot dans 14 600 pages en quelques secondes. On va ensuite lire le passage sur l'image du manuscrit original. Une lettre fausse ici ou là n'empêche pas de retrouver la plupart des occurrences, et le gain se joue surtout dans la vitesse d'accès au bon passage. Dans les archives de Notre-Dame, l'équipe travaille aussi à repérer automatiquement les noms de personnes et de lieux, pour bâtir un index.
Ce mouvement dépasse Notre-Dame. Comme le raconte